








「この絵、どこかで見た気がする」——でも確かめる方法がなかった
AIが描いた1枚のイラストに、なんとなく既視感を覚えたことはないでしょうか?
SNSでは「これは有名なアーティストの絵柄を写しただけでは?」という論争が絶えず、実際にアーティストたちがAI企業を訴える裁判は世界各地で進行中です。
こうした争いを解決するカギと考えられてきたのが、生成画像の「出どころ探し」です。
AIの出力が学習データのどれに由来するのかを特定できれば、クレジット表記や報酬の支払い、そして規制のルール作りにも道が開けます。
MITの研究チームも当初、出どころ探しの技術がAIの理解や規制に役立つと期待して研究を始めました。
ところが、この出どころ探しには大きな壁がありました。
「この画像を学習していなかったら、AIは何を描いたのか」を本当に確かめるには、その画像抜きでAIをゼロから作り直すしかありません。
学習画像は膨大にあるため、1枚ずつ確かめていくのは事実上不可能でした。
そこで研究チームは、発想を変えました。
あとから作り直すのではなく、最初から「特定の画像の影響だけをオフにできるAI」を作ってしまえばいいのです。
新開発のAI(拡散アンサンブル)は、それぞれ違う組み合わせの画像を学んだ小さなAIの集合体で、ある画像の影響を消したいときは、それを学んだ小さなAIたちをオフにするだけで済みます。
こうして「その画像を一度も見ていないAIなら何を描いたか」を、作り直しなしで正確に確かめられるようになりました。
この新型AIが描く絵の品質は従来のAIとおおむね同程度で、検証の土台は整いました。
作家データを丸ごと消しても、AIはほぼ同じ絵を描いた
方針が定まると研究チームは、公開画像のコレクションを教材に、学習データの規模をさまざまに変えながら、24通りの条件で新型AIを育て上げました。
調査にあたっては、まずAIに特定の絵を1枚描かせます。
次に学習データから絵を1枚消したとき、最初の絵からどれだけ変わったかを、消す1枚を取り替えながらすべて調べました。
結果、学習データが大きくなるほど、どの1枚を消しても絵の変化はどんどん小さくなっていったのです。
研究チームはこの現象を「帰属減衰」と名付けました。
ここでいう帰属とは、できあがったAI絵の出どころを、特定の元ネタに求めて「この絵は、あの学習材料から生まれた」と結び付けられる状態です。
その結びつきが、学習データが増えるとともに薄れていくというわけです。
しかも、消せるのは絵1枚だけではありません。
たとえばある実験では、744人の画家の作品で学習したAIに絵を1枚描かせ、画家をひとりずつ除いた744通りの「もしも」をすべて確かめました。
結果、どの画家を消しても、出てくる絵はほぼ同じだったのです。
大量の画像で学習したAIでは、学習データに含まれる「ある人物の顔写真」や「ある画家の作品」をひとまとめに消しても、出力される画像はほとんど変わりませんでした。
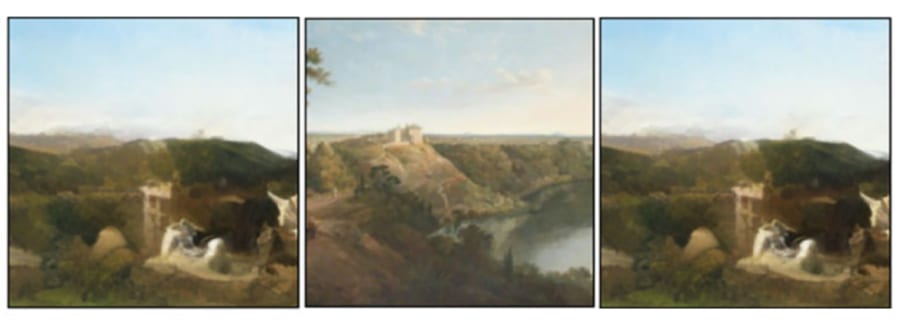
この落差を象徴するのが、絵画で学習した2つのAIの比較です。
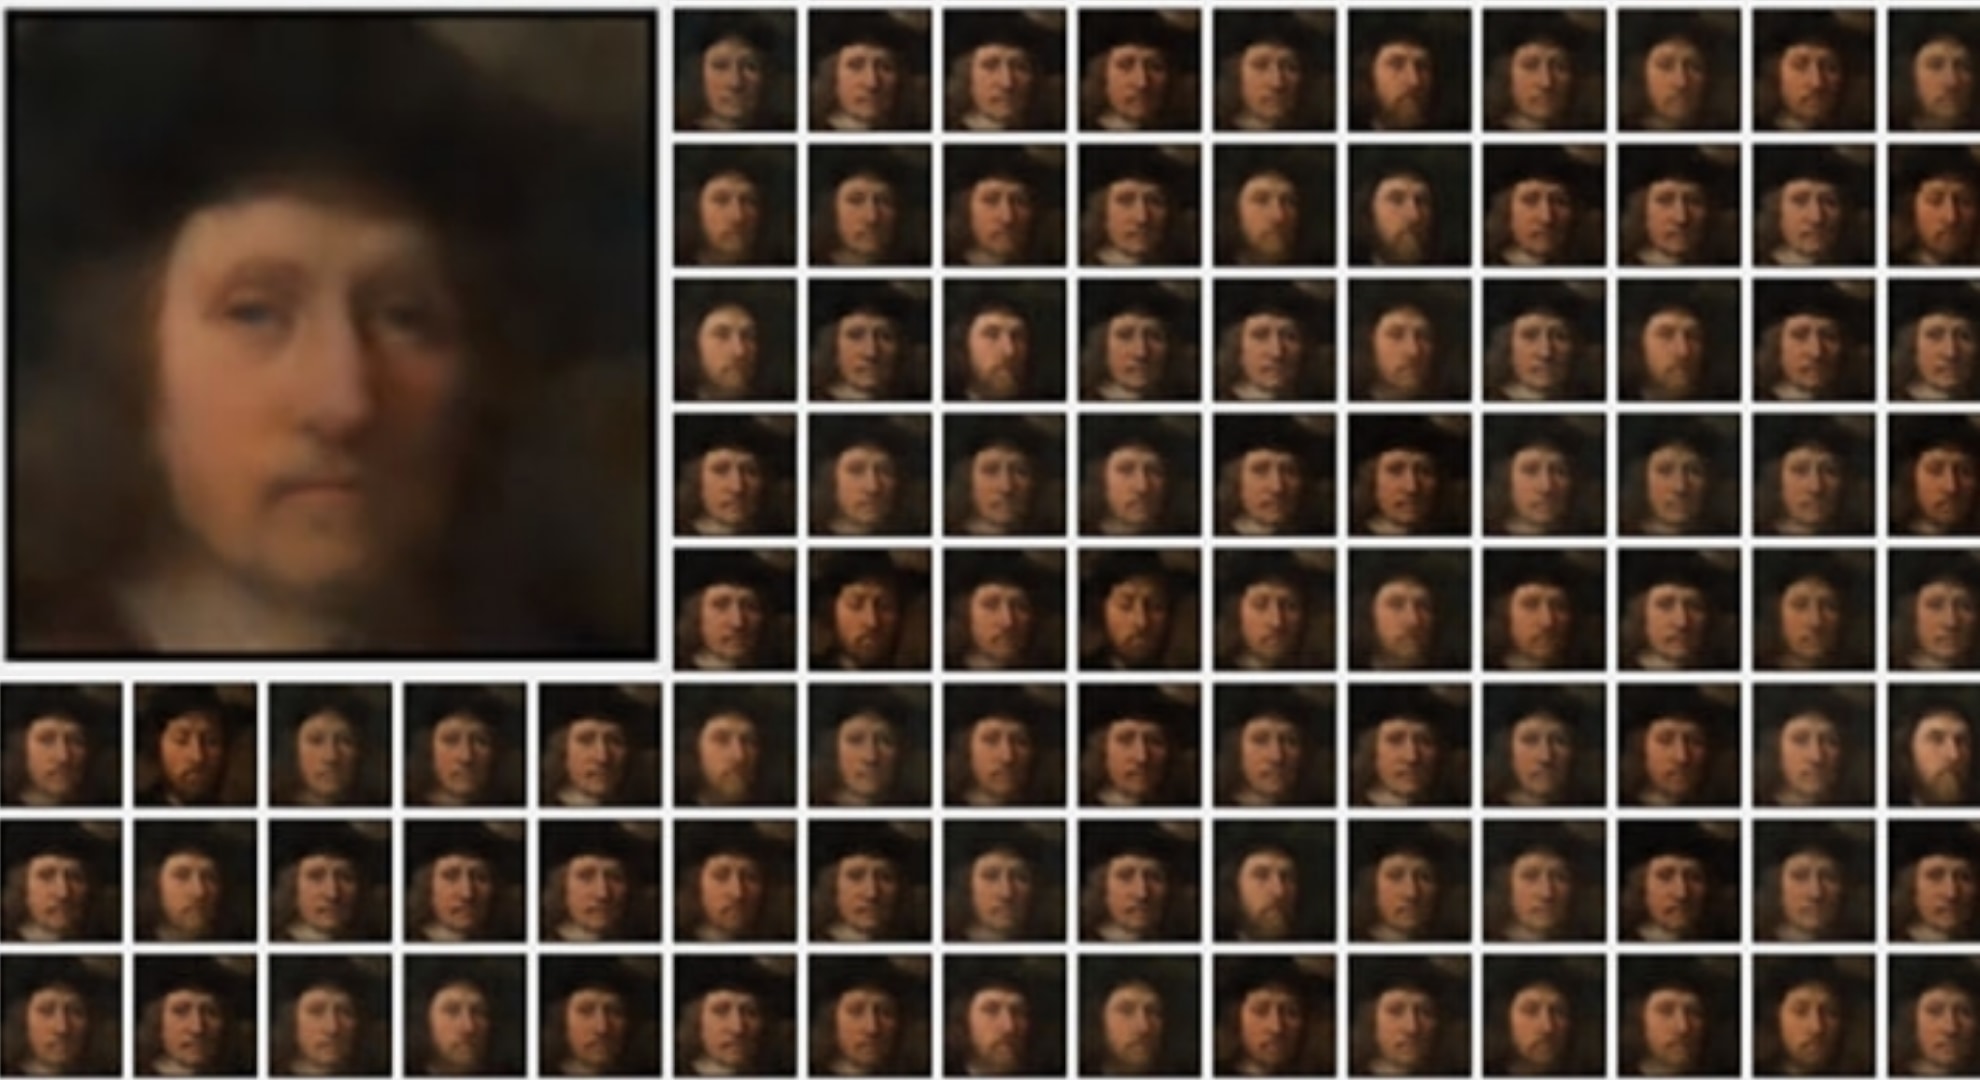
1336枚だけで学習した小さなAIでは、生成された肖像画に最も似ていたのは15世紀の絵画「祈る男」でした。
そこで、その作者候補の一人であるロバート・カンピンの作品を学習データからまとめて抜くと、出てくる絵は明らかに別物へと変わりました。
ところが5万枚の絵画で学習したAIでは、生成された風景画に最もよく似ていた18世紀の画家トマス・ジョーンズの作品を学習データからまとめて抜いても、絵はほとんど変わらなかったのです。
消しても何も変わらないのなら、そのデータは絵が生まれた原因とは言えません。
つまり大規模なAIの出力は、どれか特定の1枚や1人の”おかげ”とは言えない状態になっていたのです。
さらに「一番似ている画像を元ネタとみなす」方式の出どころ探しは、データが大きくなるほど誤りだらけになることもわかりました。
実際、研究では学習画像が増えるにつれて誤りの割合が右肩上がりに増えていくことが示されており、学習画像が数百枚のうちはある程度通用していた判定が、数万枚を超えるあたりではほとんど外れになっていたのです。
大規模なAIでは、見た目の類似だけでは「出どころ」の証拠にならなかったのです。
ですが研究チームはさらに検証を進めました。
小さなAIをオフにするという新方式そのものが、結果に影響を与えていた可能性もあったからです。
そこで今度は小規模なデータで、抜きたい画像を最初から除いた状態のAIを1282個も作り上げ、力ずくで比べました。
それでも結果は変わりませんでした。
さらに、文章の指示から絵を描くタイプのAIでも、絵の違いの測り方を変えても、結論は変わりませんでした。
消しても変わらない——この結果は、どこから突いても崩れなかったのです。
では、なぜ最もよく似た画家の作品を学習データからまとめて抜いても、出てくる絵はほとんど変わらないのでしょうか。
研究チームは、AIにとって重要な特徴が学習データのあちこちに重複して散らばっているためだと考えています。
ある画風らしさは、その画家の作品だけに宿っているものではありません。
だから一部を抜いても、別の部分が肩代わりしてしまうのです。
「○○さんの画風だ」という感想は成り立っても、その画風がその人だけから来た証拠にはならなくなっていたのです。
AIと著作権の関係を揺さぶる
この発見は、AIと著作権をめぐる議論の土台を揺さぶります。
出どころ探しが機能すれば、AIの出力と著作物の類似が「コピー」なのか「偶然の一致」なのかを判定できるはずでした。
しかも、出どころとのつながりは、学習画像が1万〜10万枚の規模ですでに大きく薄れていました。
実際に商用化されているAIには、その1万倍以上にあたる10億枚規模のデータで学習しているものもあります。
そのためコーネル大学の法学者ジェームズ・グリメルマン氏は「この論文は、AIではそれ(出どころ探し)が機能しない可能性を示しています。技術者や裁判所は、コピーを評価する別の方法に頼る必要があるでしょう」と指摘します。
そして論文は、さらに踏み込んだ警告も書いています。
著作権侵害を訴えるには「相手が自分の作品に触れていた」と示すことが要になりますが、出どころをたどれないことは、逆にその反論の材料として使われてしまいかねません。
さらにより現実的な問題として、追及が難しくなったからといって、クリエイターの被害そのものが消えるわけではありません。
論文は、著作物で学習したAIに、その著作物の代わりになる代替物を作らせて売る商用利用を、懸念すべき例として挙げています。
また重要なこととして、今回の研究は「AIは著作権を侵害していない」と証明した研究ではありません。
著者のデイビッド・ギフォード教授もこの結果をAI企業の免罪符にすべきではないと釘を刺しています。
実際、10億枚規模で学習した実用モデルでも、学習画像とほぼ同じ絵が出てくることが、およそ100万回に1回の割合で起こると報告されています。
「出どころ」がわからなくなることと、絶対にコピーが起こらないことは別の問題です。
一方でこの現象には、意外な”救い”の側面もあります。
大量の顔写真で学習したAIの場合、生成される顔画像は、学習に使われた特定の人物とは因果的に無関係であることが多く、意図せずして個人のプライバシーを守る方向に働くのです。
たとえばAIが描いた「ベンチで酔いつぶれている男性」が自分にそっくりだったとしても、その顔があなたの写真から来た証拠にはならない、というわけです。
とはいえ、絵を描く人にとっては厳しい現実が残ります。
「この出力は自分の作品に似ている、だから自分の作品が原因だ」という一点だけを技術的な根拠にして戦うことは、これから先いっそう難しくなりそうです。
私たちは長らく、AI画像の向こうには著作権をダイレクトに侵害された誰かがいると信じてきました。
「これは誰かの絵に似ている」という感覚も間違っているわけではありません。
実際、アンケートなどでその感覚が正しいことを共有することもできるでしょう。
ただ、人間が「似ている」と感じ取るその特徴は、AIの中では、たった一人の作者だけに結びついてはいませんでした。
AIは多くの作品にまたがる似た特徴を学んでおり、学習データからある作者の作品をまとめて抜いても、迂回ルートを通るように似た画像を作ってしまったのです。
「この絵は誰から来たのか」という問いそのものが、答えを持たない形に変わりつつあるのかもしれません。
論文自身も、個人や作家という単位で成り立たないのなら、残された可能性はもっと大きなまとまりの単位しかないだろうと書いています。
ひとりの作者ではなく、もっと大きな何かを一つの単位として数えたとき、失われた因果はふたたび見えてくるのかを探るという方法です。
ただ現状、どこまで大きければ機能するのか、その答えはまだ誰も持っていません。




そこで終わりにしてはもったいない、では一体どのデータを抜けばそれが崩れるのかというところまで踏み込むべきですね。
それが「本当のオリジナル」なのですから。
論旨はそういう特定のオリジナルは存在しないという話しだとおもうが
収斂進化とか、集合知とか、
ある程度の規模以上の学習データからのAIはプロンプトの内容によって出てくる結果は収束するという事だと思われる
生まれてから他人の影響を一切受けたことがない人なら、本当のオリジナルを生み出せたかもしれませんね
作者がヒトだろうがAIだろうが,著作物の類似性とは本来そのようなものではないだろうか。作者がヒトの場合の学習過程でも、初心者(手本が少数)の作品はコピーに近いが,多くの手本を目にしている場合にはなんとなく元の絵を思い起すが別の新しい作品と認識される。
(ここからが本題)昨今、著作物において、自分の作品に似ているからけしからん、金を払えとの主張が多すぎるように思われる。本来,著作物とは他人に真似され、若干の追加がなされることで発展するものであろう。似ているから金を払え、というならば、類似品の排除に関して登録商標のような扱いが必要と思う。
これって「初音ミク」で出力した画像と一番近い画風のイラストレーターを探してそのイラストレーターの画像データを削除しても「初音ミク」の出力に影響はなかったって話よな?
今は絵師タグをプロンプトに入れて画風を指定するのが主流だしあんま関係ない話かも
絵師を指定してそれっぽい絵が出力されるなら、この研究を持たずに普通に抗議できるのでは。
言葉と作風を関連付けられるということは、学習データに含まれてないと無理だし。
なんていうかさ、作品を「生成」してるんだよ。人間もAIも。生み出してるの。こんなこと説明しなきゃいけないこと自体が狂ってる。
学習データのそれぞれの作家に対する重みづけが極端に偏らないような生成物だった場合、その一つを抜いても大きく変わらないというのは驚くべき結果ではない。
100gの錘ひとつと99gの錘100個をまとめて10kgの錘を作ったとき、一番寄与率が高いのは100gの錘だが、それを抜いても1%しか変動しないようなものだ。
ただ実際は、そのように学習データ全体の寄与率がほぼ均一になるということはそう多くないだろう。ユーザーの指示によって、使えるデータは絞り込まれていく。10kgのうち4kgが特定の作家、といった偏った生成物も当然あり得るだろう。そのような場合は、その4㎏にあたる作家をまるごと抜いたら大きく変化するだろうし、その作家が「元ネタ」だと言える。
記事のタイトルは「元ネタ探しは不可能」だが、この論文は「どの特定の作家・作品にも決定的に依存しないような生成物が存在しうる」ことしか言えていないように思われる。