

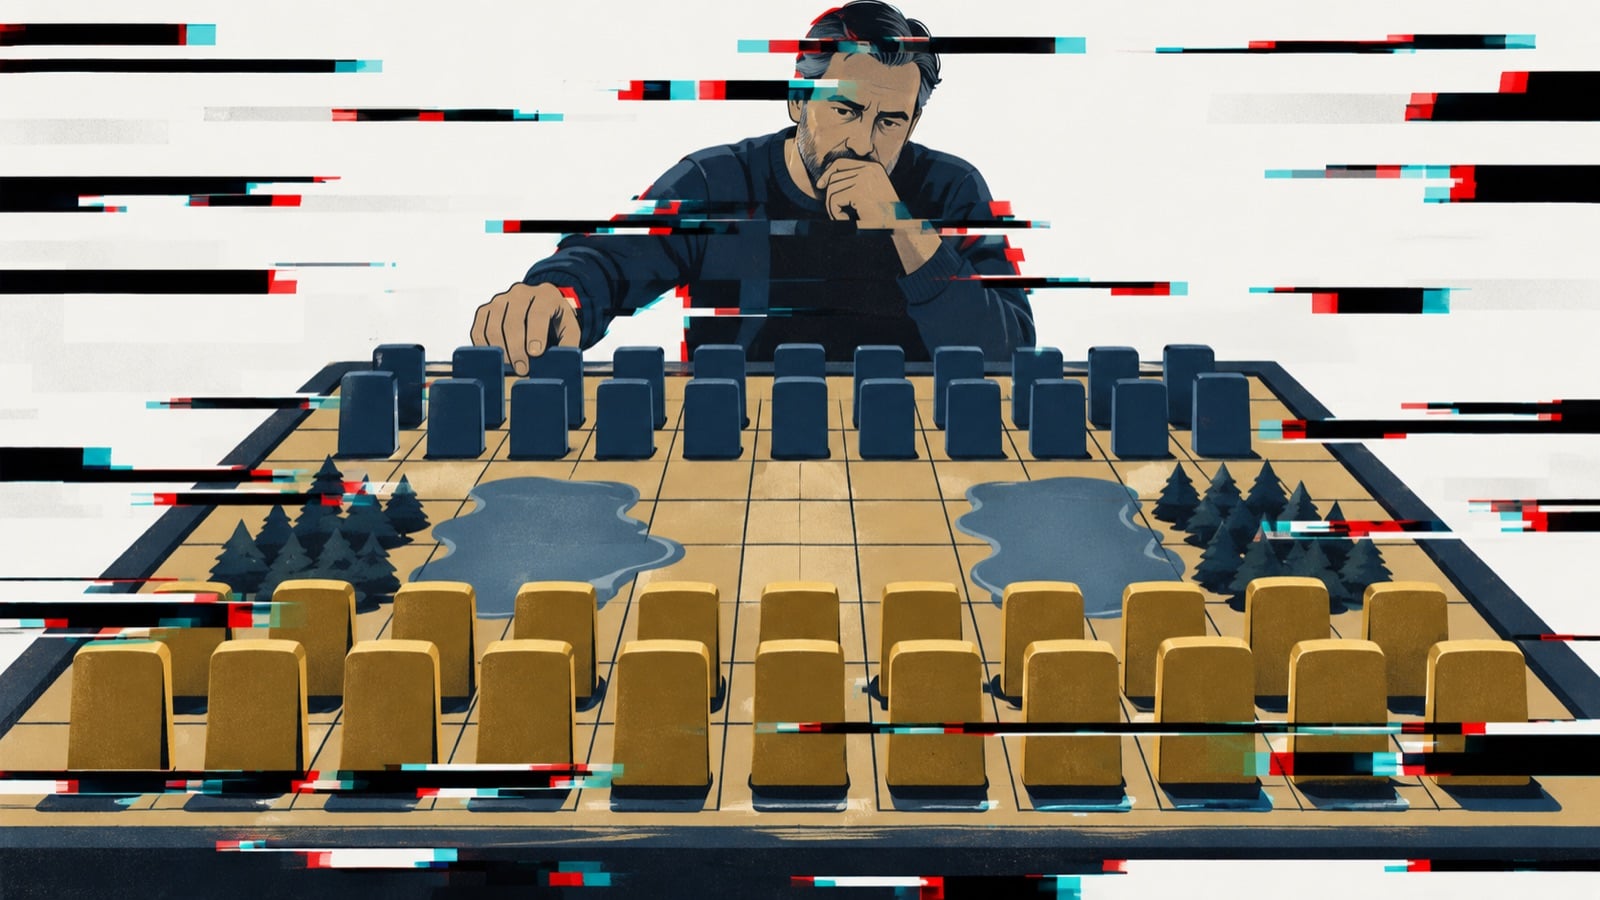
見えない駒をどう読む? アタラクソスが勝負に持ち込んだ2つの工夫
アタラクソスの土台は、自分自身との対戦を繰り返して強くなる「自己対戦」による強化学習です。
勝ちにつながった手はより多く、負けにつながった手はより少なく指すように学ぶという発想は、DeepNashと同じでした。
アタラクソスが自分自身と戦った対局は、合計1億6300万局にのぼります。
違ったのは、1局ごとに戦略をどれだけ変えるかの加減です。
隠れた情報があると、自己対戦の学習は同じところをぐるぐる回りやすくなります。
そこで研究チームは、学習の序盤では戦略を大胆に変え、後半では小さく慎重に変えるようにしました。
さらに大きな工夫が、DeepNashには無かった「一手ごとに先を読む」仕組みです。
AlphaGoのようなAIは指す直前に先読みをして戦略を磨きますが、ストラテゴでは考えるべき可能性が多すぎて、DeepMindはこれを実現できませんでした。
研究チームが用意したのは、相手の駒がこれまでどう動いてきたかからその正体を推測する「信念モデル」というニューラルネットワーク(脳の神経回路をまねた計算の仕組み)です。
アタラクソスはありうる配置をすべて調べる代わりに、もっともらしい配置をいくつか抜き出し、それぞれで候補の手を試しに進めて、結果の良い手を選びます。
見えない駒を全部数え上げるのではなく、「ありそうな駒」に絞って読むわけです。
論文によると、ストラテゴほど隠れた情報が多いゲームで指す直前に先読みするのは大きな難題とされ、これまでの研究は事実上それをあきらめていました。
こうして鍛えたアタラクソスが挑んだ相手は、ピム・ニーマイヤー氏です。
ニーマイヤー氏は世界選手権を4度制し、世界ランキング1位の座に600週以上ついてきた、史上最高とも言われるプレイヤーです。
ニーマイヤー氏は3週間にわたってオンラインで20局を戦い、1勝するごとに100ドルを受け取る条件でした。
AIが自分に合わせて戦い方を変えないと分かっていたので、弱点を探す時間は十分にありました。
それでも結果は、アタラクソスの15勝1敗4分けでした。
研究チームの知る限り、これはストラテゴの歴史で初めて、AIが人間を超える強さを示した結果です。
以前ナゾロジーではこういう記事も紹介しています(AIがチェスで圧勝する理由の一端が見えてきた――「ややこしいまま耐える」時間が人間より長い)
唯一の1敗について研究チームは欠点ではないとし、駒の並べ方をランダムにする必要があるこのゲームでは運が必ず絡むと説明しています。
論文のシニア著者でMITのガブリエーレ・ファリーナ助教は「完璧な戦略でも、ときには負けるのです」と話しています。
2025年のストラテゴ世界選手権でも、会場でアタラクソスに挑んだ参加者たちは40局中38局で敗れました。